Tacit Talk |
Ein sprachbasiertes hybrides KI-System zur Erfassung von implizitem Instandhaltungswissen
 , Philipp Besinger, Joscha Zaremba
, Daniel Valtiner
, Michael Necemer
, Safa Omri
, Jens Neuhüttler
, Fazel Ansari
, Katharina Hölzle
| Zeitschrift | Industry 4.0 Science |
| Ausgabe | 42. Jahrgang, 2026, Ausgabe 5, Seite 82-90 |
| Open Access | https://doi.org/10.30844/I4SD.26.5.16 |
| Literatur | Teilen | Zitieren | Download |
Abstract
Keywords
Artikel
Ein Großteil des Fachwissens, das den industriellen Wartungsbetrieb am Laufen hält, wird nie schriftlich festgehalten. Erfahrene technische Fachkräfte verlassen sich auf Intuition, sensorische Hinweise und improvisierte Lösungen – Wissen, das zutiefst persönlich und kontextabhängig ist. Ob aufgrund von Pensionierungen, Personalfluktuation oder zunehmender Spezialisierung, Unternehmen sehen sich einem zunehmenden Risiko gegenüber: Entscheidendes Know-how geht verloren, wenn die Menschen, die es besitzen, das Unternehmen verlassen.
Abgesehen vom demografischen Wandel bedeutet die zunehmende Komplexität der Systeme, dass selbst stabile Teams Schwierigkeiten haben, Fachwissen zu dokumentieren, das sich einer Formalisierung entzieht [1]. Herkömmliche Ansätze wie Wikis, statische Dokumentation oder informelles Mentoring haben sich bei der Erfassung dieses Erfahrungswissens nur begrenzt bewährt [2].
Bestehende KI-gestützte Ansätze zum Wissensmanagement setzen voraus, dass Wissen bereits in strukturierter Form vorliegt. Die systematische Erfassung neuen impliziten Wissens, ohne dabei die betrieblichen Arbeitsabläufe zu stören, bleibt weitgehend unberücksichtigt. Sprachbasierte Interaktion bietet hier einen vielversprechenden Ansatz, da sie die Dokumentationshürde Mitarbeitende, deren Hände bei der Arbeit gebunden sind, senkt und die Erfassung von Wissen genau in dem Moment ermöglicht, in dem es am relevantesten ist.
Aufbauend auf bisheriger Literatur zum KI-gestützten Wissensmanagement in der Instandhaltung [3] stellt dieser Beitrag „Tacit-TALK“ vor, ein sprachbasiertes System, das es technischen Fachkräften ermöglicht, implizites Wissen durch natürliche, KI-gesteuerte Gespräche zu externalisieren. In der Erkenntnis, dass die Wissenserfassung in betrieblichen Umgebungen ebenso sehr eine organisatorische, wie eine technische Herausforderung darstellt, verfolgt das Systemdesign durchgehend einen soziotechnischen Ansatz, der Automatisierung und menschliches Handeln sowie individuellen Beitrag und kollektiven Nutzen in Einklang bringt. Das System wurde nach einer Design-Science-Research-Methodik entwickelt und als Proof-of-Concept in der Halbleiterwartung umgesetzt.
Die Beiträge sind:
- Soziotechnische Gestaltungsprinzipien für die KI-gestützte Erfassung impliziten
- Wissens
- Eine Referenzarchitektur, die LLMs mit einem persistenten Wissensgraphen für
- den Bereich der betrieblichen Instandhaltung kombiniert
- Erste Erkenntnisse aus Prototypenentwicklungen zur Nutzendenakzeptanz und zu
- organisatorischen Auswirkungen
Implizites Wissen und Wissensverlust in Organisationen
Die Unterscheidung zwischen implizitem und explizitem Wissen, die auf Polanyis Beobachtung beruht, dass „wir mehr wissen, als wir sagen können“, ist nach wie vor grundlegend für die Forschung im Bereich Wissensmanagement [4, 5]. Wissensverlust durch das Ausscheiden von Mitarbeitenden führt zu messbaren Einbußen bei der Produktivität und der organisatorischen Leistungsfähigkeit [6].
Wissensmanagement 4.0 definiert diese Herausforderung neu und macht es zu einer strategischen Funktion intelligenter Fabriken, die Wissensgenerierung und -nutzung über Mensch-Maschine-Kollektive hinweg in Einklang zu bringen [7]. Während verhaltensorientierte Ansätze wie Gamification und Nudging zur Förderung des Wissensaustauschs untersucht wurden [8], adressieren sie nicht die grundlegende Herausforderung, verkörpertes und kontextspezifisches Erfahrungswissen in operativen Instandhaltungsumgebungen zu externalisieren.
Jüngste Fortschritte bei Large Language Models (LLMs) und der Retrieval-Augmented Generation (RAG) haben neue Wege für das Wissensmanagement (KM) in der industriellen Instandhaltung eröffnet. Die auf RAG basierende Generierung reduziert Halluzinationen in Instandhaltungsanweisungen und -maßnahmen. Für Halbleiteranwendungen wurden domänenspezifische LLMs entwickelt [9, 10]. Diese Ansätze setzen jedoch voraus, dass Wissen bereits in strukturierter Form vorliegt – keiner befasst sich mit der Erfassung neuen impliziten Wissens durch natürliche Interaktion. In unseren bisherigen Arbeiten wurden die Anforderungen an die Integration einer LLM-basierten Wissensextraktion in organisationale Wissensbasen identifiziert und damit die Grundlage für die vorliegende Forschung geschaffen [3].
Die meisten KM-Systeme basieren auf textbasierten Eingaben und stellen damit eine Hürde für technische Fachkräfte dar, die während der Arbeit anderweitig beschäftigt sind. Frühere Arbeiten zur sprachbasierten Annotation in CAD-Umgebungen haben gezeigt, dass Sprache eine natürlichere und niedrigschwelligere Interaktionsform bietet [11]. Die konkrete Extraktion strukturierten impliziten Wissens aus unstrukturierter Sprache ist jedoch bislang nicht adressiert worden. Genau diese Forschungslücke soll Tacit-TALK schließen.
Design-Science-Research-Methodik
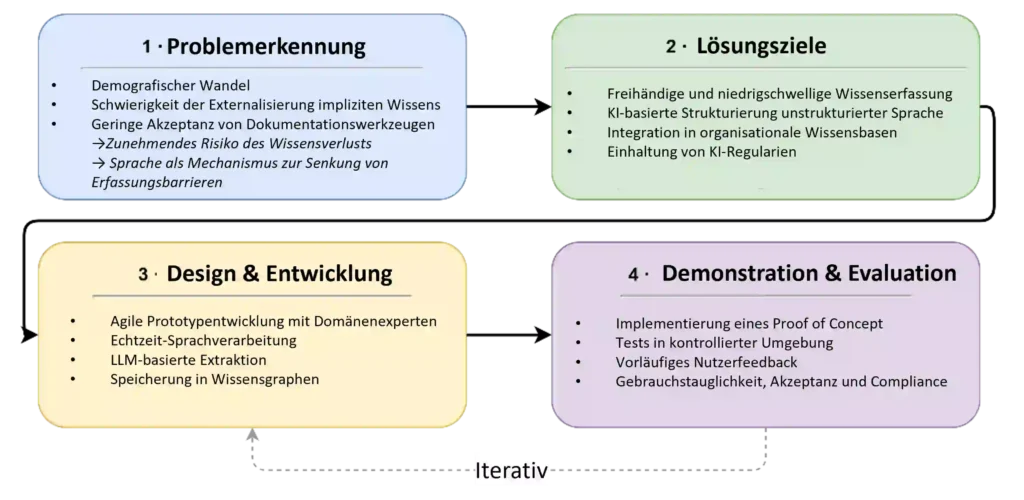
Diese Forschung folgt dem Design-Science-Research-Paradigma (DSR) [12, 13], da die Entwicklung eines Artefakts für den Einsatz in einem komplexen soziotechnischen Arbeitssystem iterative Zyklen der Gestaltung, Demonstration und Evaluation erfordert und nicht durch einen rein erklärungsorientierten Forschungsansatz abgebildet werden kann. Der Forschungsprozess umfasst vier iterative Phasen (Bild 1).
Zur Priorisierung von Stakeholder-Werten und Unternehmenszielen im Anforderungserhebungsprozess wurde ein wertebasierter Engineering-Ansatz angewendet [14].
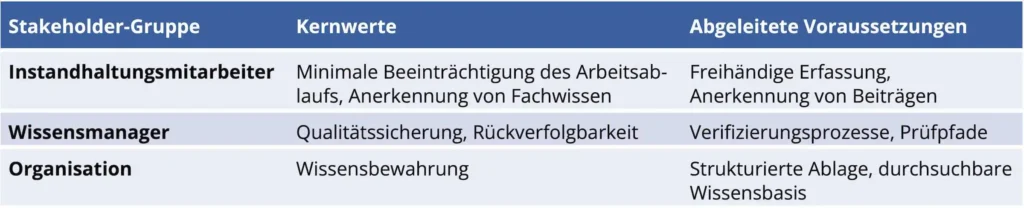
Die Zuordnung (Bild 2) offenbarte drei grundlegende Zielkonflikte:
- Benutzerfreundlichkeit versus Datenqualität (vereinfachte Eingabe kann die
- Granularität verringern)
- Automatisierung versus Kontrolle (die Strukturierung durch KI kann Fehler
- verursachen)
- Offenheit versus Datenschutz (beim Datenaustausch müssen Datenschutzbedenken berücksichtigt werden)
Anhand einer wertgewichteten Priorisierung identifizierten wir vier kritische Anforderungen in absteigender Reihenfolge:
- Sprachbasierte Eingabe mit Transkriptions-Feedback in Echtzeit
- „Human-in-the-Loop“-Verifizierung, bevor Wissen offiziell wird
- Transparente KI-Verarbeitung mit erklärbaren Ergebnissen
- Rollenbasierte Zugriffskontrolle mit klarer Datenhoheit
Um die identifizierten Werte in konkrete Designentscheidungen umzusetzen, haben wir vier repräsentative, auf Rollenprofilen basierende Personas erstellt, die während strukturierter Workshops mit Instandhaltungsleitenden und Teamleitenden am Standort unseres Halbleiterpartners ermittelt wurden. Jede Persona fasst beobachtete Merkmale, Einschränkungen und Motivationen tatsächlicher Nutzendengruppen zusammen:
- Eine Person aus der Instandhaltung mit begrenzter Zeit für die Dokumentation und Bedenken hinsichtlich Überwachung
- Eine allgemeine nutzende Person, die spontane Erkenntnisse festhalten möchte
- Eine prüfende Person, die für die Validierung von Einträgen anhand einheitlicher Standards verantwortlich ist
- Eine neu einsteigende Person, deren Schwerpunkt auf einer reibungslosen Einarbeitung liegt
Auf Grundlage dieser Personas wurden User Journey Mapping Sitzungen durchgeführt, um Interaktionspunkte und Gestaltungsanforderungen entlang von fünf Phasen der User Journey zu identifizieren. Ziele, Herausforderungen und daraus abgeleitete Gestaltungsmaßnahmen sind in Bild 3 zusammengefasst.
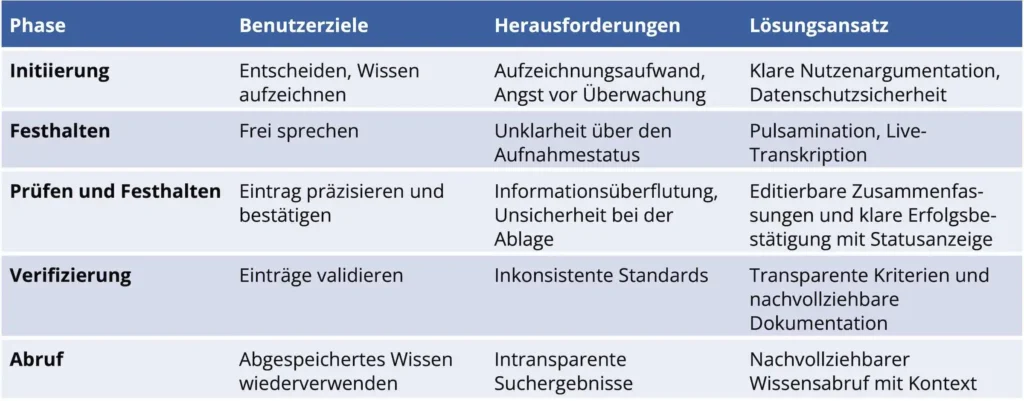
Drei übergreifende Erkenntnisse prägten die anschließende Gestaltung des Systems. Erstens benötigen Nutzende während der sprachbasierten Erfassung unmittelbares visuelles Feedback, um Vertrauen in die Funktionsfähigkeit des Systems zu entwickeln. Zweitens muss die Unterscheidung zwischen einem nicht verifizierten und einem verifizierten Status transparent kommuniziert werden, um Unsicherheiten hinsichtlich verlorener oder abgelehnter Beiträge zu vermeiden. Drittens muss die Abrufphase nachvollziehbare Begründungen für vorgeschlagene Verknüpfungen bereitstellen, damit Nutzende verstehen, warum bestimmte Einträge angezeigt werden. Auf diese Gestaltungsentscheidungen wird im weiteren Verlauf des Beitrags näher eingegangen.
Systemdesign
Das System erweitert bestehende Instandhaltungsontologien, um Artefakte impliziten Wissens aufzunehmen, die durch gesprächsbasierte Interaktion erfasst werden. Das Datenmodell ist als Labeled Property Graph implementiert und ermöglicht sowohl strukturierte Abfragen als auch eine semantische Ähnlichkeitssuche. Die bestehende Instandhaltungsontologie wird um Konzepte erweitert, die speziell für die Erfassung impliziten, erfahrungsbasierten Wissens entwickelt wurden:
Insight
├── problem_context # Trigger
├── action_taken # Response
└── lesson_learned # Takeaway
TacitCategory
├── Deviation # Differs from SOP
├── Intuition # Gut feeling
├── Hack # Workaround
├── Info_Gap # Undocumented
└── Hot_Fix # Emergency solution
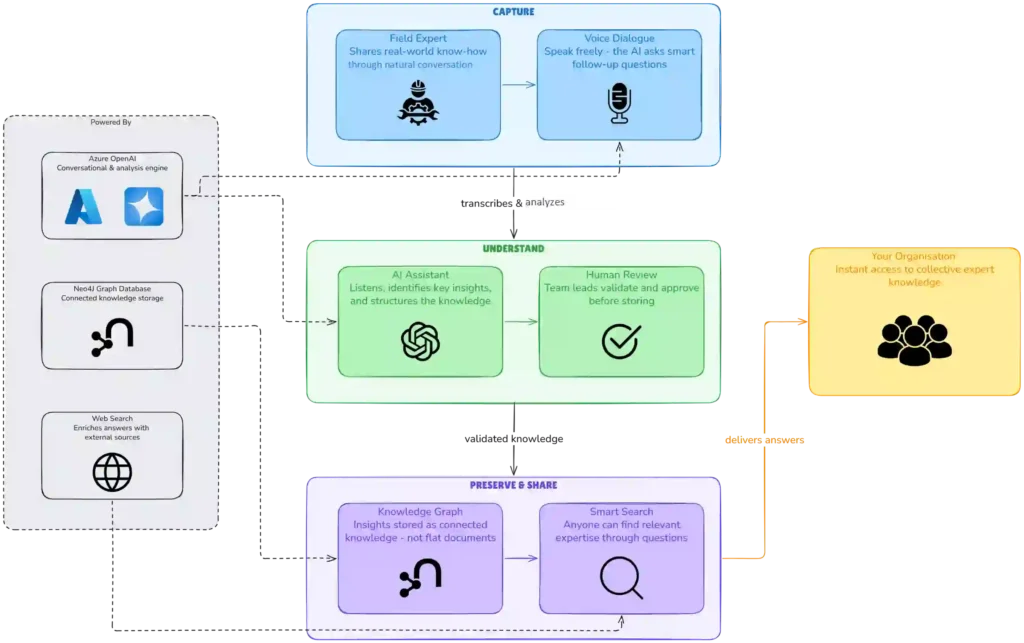
Die Architektur integriert drei Teilsysteme (Bild 4):
- Eine Sprachverarbeitungspipeline für die Echtzeittranskription und den sprachbasierten Dialog
- Eine LLM-Orchestrierungsschicht, die den Dialogzustand, die Auswahl geeigneter Wissenserhebungstechniken sowie die strukturierte Wissensextraktion steuert
- Eine Wissensgraph-Persistenzschicht, die neue Erkenntnisse mittels einbettungsbasierter Entitätszuordnung mit bestehenden Organisationsdaten verknüpft
Alle Knoten verfügen über Vektoreinbettungen, wodurch eine Graph-RAG-basierte Informationsabfrage ermöglicht wird: Zur Beantwortung einer Anfrage werden die zur Suchanfrage passenden Knoten zusammen mit ihren Graphnachbarschaften als kontextuell angereicherte Eingabe für die Antwortgenerierung zusammengeführt.
Proof of Concept
Der Proof of Concept von Tacit-TALK wurde als Webanwendung implementiert (Bild 5).
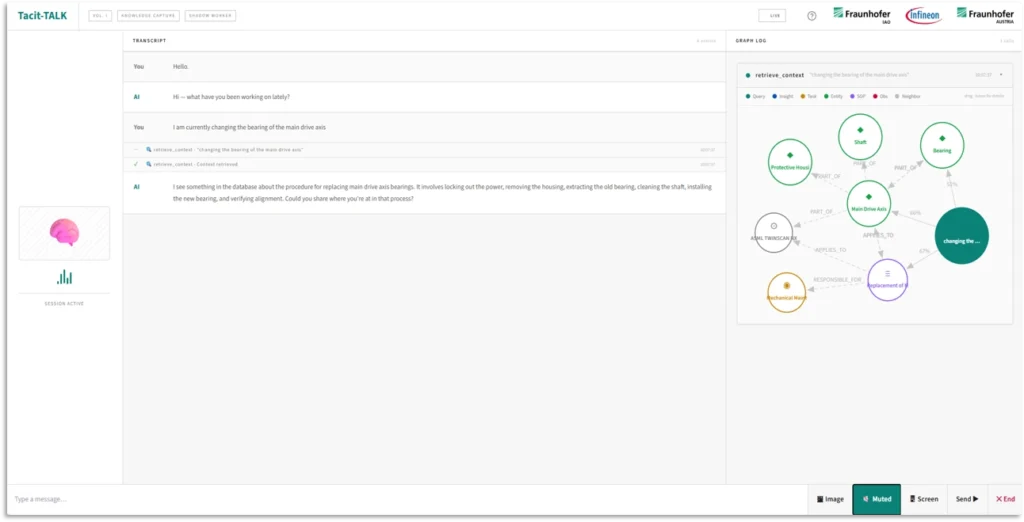
Eine typische Erfassungssitzung beginnt, wenn eine technische Fachkraft nach Abschluss einer Instandhaltungsaufgabe eine neue Aufzeichnung startet. Das System begrüßt Nutzende sprachbasiert mit einer offenen Eingangsfrage. Während die technische Fachkraft spricht, wird die Transkription in Echtzeit auf dem Bildschirm angezeigt und liefert kontinuierliches Feedback. Der Konversationsagent führt den Dialog anschließend, wie im weiteren Verlauf dieses Abschnitts beschrieben.
Nach Abschluss erstellt das System eine strukturierte Zusammenfassung, die von Nutzenden überprüft und bearbeitet werden kann, wodurch das Human-in-the-Loop-Prinzip unterstützt wird. Der daraus resultierende Insight-Knoten wird mit dem Status Unverified gespeichert. So kann beispielsweise ein erfasster Eintrag den Austausch eines Lagers im Rahmen einer Notfallreparatur dokumentieren, als Erkenntnis des Typs Intuition klassifiziert sein und den auslösenden Zustand (z. B. eine Sensormeldung), die durchgeführte Maßnahme sowie eine übertragbare Erkenntnis zur Ausrichtung der Schmierung enthalten.
Die KI-gestützte Gesprächsführung von Tacit-TALK unterstützt die systematische Erfassung impliziten Wissens und bewahrt gleichzeitig den natürlichen Charakter eines gesprochenen Austauschs. Das Dialogdesign folgt vier Grundprinzipien:
- Es wird jeweils nur eine Frage gestellt, um eine kognitive Überlastung zu vermeiden
- Nachfragen werden an den Gesprächsverlauf und bestehende Wissenslücken angepasst
- Das System greift nur dann ein, wenn dies tatsächlich erforderlich ist, damit das Gespräch nicht den Charakter eines Verhörs annimmt
- Der Dialog kann jederzeit geordnet beendet werden, sodass auch unvollständige Erfassungen einen Mehrwert bieten
Ein Prompt-Sequencer setzt diese Prinzipien um, indem er zwischen empirisch fundierten Wissenserhebungstechniken wechselt, die situatives Erinnern, Schlussfolgern und Entscheidungsfindung sowie den Wissenstransfer abdecken. Die Auswahl der jeweiligen Technik richtet sich danach, welche Wissensdimensionen – Problemkontext, Handlungsbegründung oder übertragbare Erkenntnis – bislang nur unzureichend erfasst wurden. Eine Zustandsmaschine führt den Dialog von einer offenen Erzählphase über eine Schleife aus Nachfragen, Klärungen und graphbasierter Kontextabfrage bis hin zur Erstellung einer Zusammenfassung und deren Bestätigung durch Nutzende.
Der Proof of Concept zeigt, wie die erfassten Erkenntnisse in den bestehenden Wissensgraphen der Organisation integriert werden. Das Extraktionsmodul identifiziert Verweise auf Maschinen, Komponenten und Werkzeuge und gleicht diese mithilfe einer auf Einbettungen basierenden Kosinusähnlichkeit mit bereits vorhandenen Graphknoten ab. Dadurch wird der sprachbedingten Unschärfe gesprochener Äußerungen Rechnung getragen. Ein neuer Entitätsknoten wird nur dann erzeugt, wenn keine Übereinstimmung einen hohen Konfidenzwert überschreitet. Dadurch werden sowohl doppelte Einträge als auch fehlerhafte Zusammenführungen vermieden. Jeder Eintrag wird mit seiner authentifizierten erstellenden Person verknüpft, wodurch die Identifikation von Expertinnen und Experten ermöglicht wird, während personenbezogene Informationen ausschließlich für entsprechend berechtigte Rollen zugänglich sind.
Jede neue Aufgabe wird automatisch mit den Einbettungen bestehender SOP-Dokumente verglichen. Ist die Ähnlichkeit ausreichend hoch, wird – vorbehaltlich der Bestätigung durch eine prüfende Person – eine RELATED_SOP-Beziehung erzeugt. Im Laufe der Zeit entsteht dadurch ein Anreicherungseffekt für SOPs: Formale Arbeitsanweisungen werden schrittweise um erfahrungsbasierte Anmerkungen ergänzt und erfassen dadurch Wissen, das in der Dokumentation allein nicht enthalten ist.
Diskussion und Limitationen
Tacit-TALK zeigt, dass eine sprachbasierte, KI-gestützte Interaktion für die Erfassung impliziten Wissens in der industriellen Instandhaltung durchaus geeignet ist. Diese Forschungslücke wurde in der bisherigen Literatur zu KI-gestütztem Wissensmanagement zwar identifiziert, jedoch nicht adressiert, da bestehende Ansätze bereits strukturierte Eingaben voraussetzen [9, 10]. Im Unterschied zu früheren Arbeiten zur sprachbasierten Annotation, die sich auf explizite Konstruktionsartefakte beschränkten [11], nutzt unser System eine LLM-gestützte Wissensextraktion, um Wissen sichtbar zu machen, das Beschäftigte selbst häufig nicht als dokumentationswürdig wahrnehmen.
Der wertorientierte Requirements-Engineering-Prozess zeigte, dass die zentrale Gestaltungsherausforderung nicht in der technischen Umsetzbarkeit, sondern in der soziotechnischen Ausgewogenheit liegt. Mitarbeitende sind bereit, ihr Wissen zu teilen, wenn das System als Instrument der Wertschätzung und nicht der Überwachung wahrgenommen wird und der Dokumentationsaufwand den Arbeitsablauf nicht beeinträchtigt. Dieses Ergebnis steht im Einklang mit den Prinzipien von Knowledge Management 4.0, nach denen Wissensprozesse als kollaborative Mensch-Maschine-Funktionen verstanden werden [7].
Der Einsatz der sprachbasierten Wissenserfassung in der Halbleiterinstandhaltung bringt domänenspezifische Herausforderungen mit sich, die über die Anforderungen herkömmlicher Spracherkennung hinausgehen. Technische Fachkräfte wechseln im Arbeitsalltag häufig zwischen Sprachen, wobei deutsche Satzstrukturen mit englischen Fachbegriffen kombiniert werden. Dies führt zu Äußerungen wie „Fehler am Platen behoben“ oder „Crash nach Aligner Error“ und erfordert robuste mehrsprachige Verfahren sowie die Unterstützung von Code-Switching innerhalb der Transkriptionspipeline. Hinzu kommen hohe Umgebungsgeräusche in der Fertigung sowie Reinraumanzüge, die die Sprache dämpfen und Gesichtshinweise verdecken, wodurch die Erkennungsgenauigkeit zusätzlich beeinträchtigt wird. Die Bewältigung dieser Herausforderungen erfordert gezielte Evaluierung und architektonische Anpassungen, beispielsweise den Einsatz rauschrobuster Sprachmodelle sowie die Feinabstimmung auf domänenspezifisches Vokabular.
Darüber hinaus sind mehrere Einschränkungen zu berücksichtigen. Der aktuelle Proof of Concept wurde bislang noch keiner systematischen empirischen Evaluierung unterzogen. Aussagen zur Nutzendenakzeptanz und zur Qualität des erfassten Wissens sind daher als vorläufig zu betrachten. Zudem setzt die Integration in den Wissensgraphen bereits vorhandene strukturierte Organisationsdaten, wie Anlagenregister, Standardarbeitsanweisungen (SOPs) und Arbeitsaufträge, voraus. Organisationen mit nur gering ausgeprägten Wissensbasen könnten daher nur eingeschränkt von dem System profitieren. Zukünftige Arbeiten werden sich auf die empirische Evaluation mit technischen Fachkräften, multimodale Eingabeverfahren, die Sprache mit Sensordaten kombinieren, sowie auf die Weiterentwicklung der Ontologie auf Grundlage praktischer Erfahrungen konzentrieren.
Zusammenfassend lässt sich festhalten, dass die erfolgreiche Externalisierung impliziten Wissens in der industriellen Instandhaltung nicht allein technische Leistungsfähigkeit erfordert, sondern eine bewusst gestaltete soziotechnische Systemgestaltung voraussetzt. Tacit-TALK bietet hierfür einen replizierbaren, auf der Design-Science-Research-Methodik basierenden Ansatz, mit dem Organisationen betriebliches Erfahrungswissen angesichts des demografischen Wandels und der zunehmenden Komplexität technischer Systeme langfristig sichern können.
Literatur
[1] E. Fenoglio, E. Kazim, H. Latapie, and A. Koshiyama, „Tacit knowledge elicitation process for industry 4.0,“ Discov Artif Intell, vol. 2, no. 1, 2022, doi: 10.1007/s44163-022-00020-w.[2] Yuetong Lin, Shahhosseini AM, Badar MA, Foster T, Dean J., „A concept map-based cognitive framework for acquiring expert knowledge in industrial environment.,“ 2016 IEEE frontiers in education conference (FIE), pp. 1–5, 2016.
[3] J. Guhl et al., „Integrating Knowledge Graphs and Large Language Models for Enhanced Human-Centered Knowledge Management in Industrial Maintenance: A Case Study,“ Human-Computer Interaction – Part III. HCII 2026. Lecture Notes in Computer Science, vol 16703. Springer, 2026.
[4] H. Mohajan, „A Comprehensive Analysis of Knowledge Management Cycles,“ Journal of Environmental Treatment Techniques, vol. 4, pp. 121–129, 2016.
[5] A. Olomolaiye and C. Egbu, „Tacit vs. explicit knowledge – the current approaches to knowledge management,“ in 2005. [Online]. Available: https://api.semanticscholar.org/CorpusID:85554607
[6] P. Massingham, „Measuring the Impact of Knowledge Loss: A Longitudinal Study,“ Journal of Knowledge Management, 2018, doi: 10.1108/jkm-08-2016-0338.
[7] F. Ansari, „Knowledge Management 4.0: Theoretical and Practical Considerations in Cyber Physical Production Systems,“ IFAC-PapersOnLine, vol. 52, no. 13, pp. 1597–1602, 2019, doi: 10.1016/j.ifacol.2019.11.428.
[8] S. J. Shi, J. W. Li, and R. Zhang, „A study on the impact of Generative Artificial Intelligence supported Situational Interactive Teaching on students’ ‘flow’ experience and learning effectiveness — a case study of legal education in China,“ Asia Pacific Journal of Education, vol. 44, no. 1, pp. 112–138, 2024, doi: 10.1080/02188791.2024.2305161.
[9] L. Tao et al., „LLM-R: A Framework for Domain-Adaptive Maintenance Scheme Generation Combining Hierarchical Agents and RAG,“ 2024.
[10] C. Nguyen et al., „SemiKong: Curating, Training, and Evaluating A Semiconductor Industry-Specific Large Language Model,“ 2024.
[11] J. D. Camba, F. Naya, D. Perez-Lopez, and M. Contero, „From Voice to Knowledge: A Proposal for a Voice Annotation System to Support Collaborative Engineering Design Processes,“ in Proceedings of the 53rd Hawaii International Conference on System Sciences, 2020.
[12] A. Hevner et al., „Design Science in Information Systems Research,“ Management Information Systems Quarterly, vol. 28, p. 75, 2004.
[13] K. Peffers, T. Tuunanen, M. Rothenberger, and S. Chatterjee, „A design science research methodology for information systems research,“ Journal of Management Information Systems, vol. 24, pp. 45–77, 2007.
[14] S. Spiekermann, Value-Based Engineering: De Gruyter, 2023
Potenziale: Management Qualifizierung
Lösungen: Instandhaltung
Das könnte Sie auch interessieren